

Biais algorithmique : les enjeux pour la PME
Le Défenseur des droits et la CNIL l’ont résumé dès 2020 : derrière l’apparente neutralité des algorithmes, des biais peuvent apparaître dès la conception et lors du déploiement. Les bases de données qui alimentent un système peuvent transmettre des biais, et les stéréotypes de ceux qui le conçoivent peuvent se retrouver reproduits automatiquement. La CNIL cite le cas d’un outil d’évaluation de CV vidéo qui ne tenait pas compte de la diversité des accents. Le recrutement est un terrain sensible, car un biais y devient vite une discrimination.
L’AI Act en tient compte. Pour les systèmes à haut risque, l’article 10 impose aux fournisseurs d’examiner leurs jeux de données au regard des biais possibles et de prendre des mesures pour les détecter, les prévenir et les atténuer, avec des données pertinentes et suffisamment représentatives. Le déployeur qui maîtrise les données d’entrée doit veiller à la même pertinence. Depuis le 27 juillet 2026, un nouvel article 4 bis, issu de l’omnibus, autorise sous conditions strictes le traitement de données sensibles lorsqu’il est strictement nécessaire pour détecter et corriger des biais.
Les biais ne concernent pas que les outils de recrutement. Un assistant génératif peut reproduire des stéréotypes dans un texte ou une image, et un modèle de scoring client peut défavoriser un territoire mal représenté dans l’historique. La CNIL recommande de vérifier l’absence de biais discriminatoires dans les résultats et met en garde contre le biais d’automatisation, cette tendance à faire trop confiance à la machine. La qualité des données est souvent la première cause, et le premier levier.
Notre réflexe tient en trois étapes : tester l’outil sur des cas fictifs appariés, identiques à un critère près ; comparer les résultats entre groupes ; garder une décision humaine pour tout ce qui touche une personne. C’est une pratique simple à intégrer dans votre démarche d’intelligence artificielle, avant qu’un écart ne devienne un contentieux.
Exemple
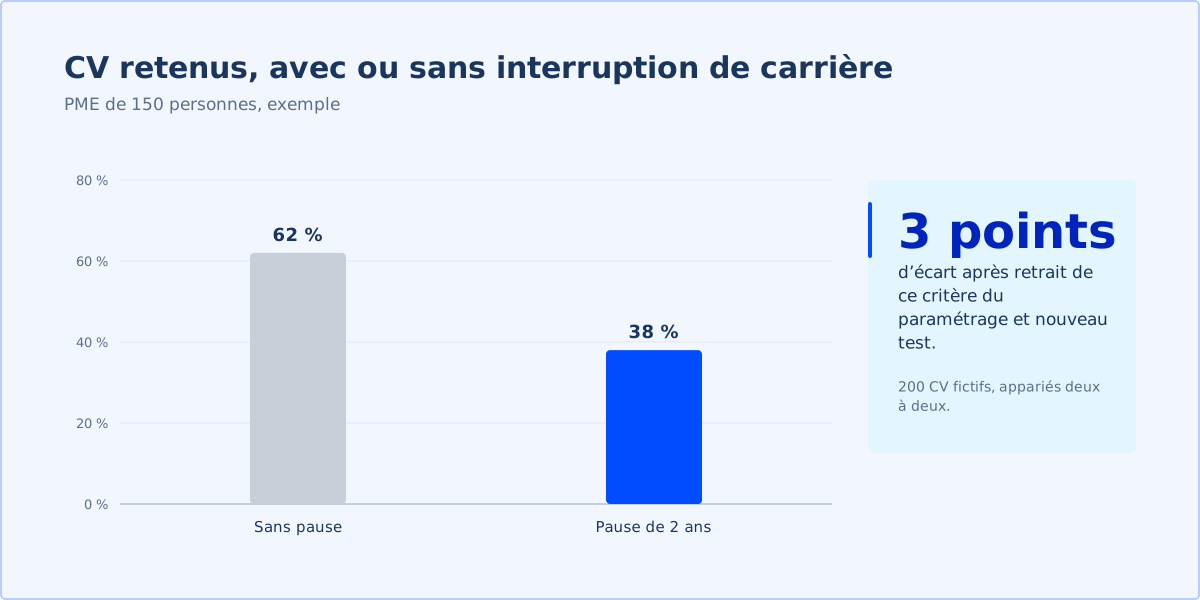
Une entreprise de logistique de 150 salariés teste son outil de présélection de candidatures avant de l’utiliser. Elle crée 200 CV fictifs, appariés deux à deux : mêmes compétences et même expérience, la seule différence étant une interruption de carrière de deux ans. Les profils sans interruption sont retenus à 62 %, ceux avec interruption à 38 %. Après retrait de ce critère du paramétrage et nouveau test, l’écart tombe à 3 points.
Questions fréquentes
D’où viennent les biais algorithmiques ?
Principalement des données qui ont servi à entraîner le système, lorsqu’elles sont peu représentatives ou reflètent des inégalités passées, et des choix faits lors de sa conception, comme les critères retenus.
Comment détecter un biais dans un outil d’IA que l’on utilise ?
En le testant sur des cas fictifs identiques à un critère près, puis en comparant les résultats. Un écart net et répété entre deux groupes signale un biais à examiner avec l’éditeur.
L’AI Act impose-t-il de corriger les biais ?
Pour les systèmes à haut risque, oui : l’article 10 oblige les fournisseurs à examiner les biais possibles et à prendre des mesures pour les détecter, les prévenir et les atténuer. Les déployeurs doivent veiller à la pertinence des données d’entrée qu’ils maîtrisent.
Qu’est-ce que le biais d’automatisation ?
C’est la tendance à accepter un résultat produit par une machine sans le remettre en question. La CNIL recommande d’en prévenir les utilisateurs et de faire vérifier les résultats par un humain.
Sources
- Algorithmes et discriminations : le Défenseur des droits, avec la CNIL, appelle à une mobilisation collective, CNIL — consulté le 16 octobre 2026
- IA : comment être en conformité avec le RGPD ?, CNIL — consulté le 16 octobre 2026
- Article 10 : Data and Data Governance, artificialintelligenceact.eu — consulté le 16 octobre 2026
- Article 4a : Processing of special categories of personal data for bias detection and correction, artificialintelligenceact.eu — consulté le 16 octobre 2026
- Article 26 : Obligations of Deployers of High-Risk AI Systems, artificialintelligenceact.eu — consulté le 16 octobre 2026
- Les questions-réponses de la CNIL sur l’utilisation d’un système d’IA générative, CNIL — consulté le 16 octobre 2026
- Digital Omnibus on AI (règlement (UE) 2026/1744), artificialintelligenceact.eu — consulté le 16 octobre 2026
Auteur

Clément Marchal a fondé le Cabinet Flourens. Depuis 2017, dont cinq ans à faire tourner des équipes, notamment dans un environnement régulé par l'AMF, il voit la même chose : l'IA entre dans l'entreprise par les salariés, pas par la direction. Personne ne sait qui l'utilise, sur quelles données, ni ce qu'elle rapporte. Avec Ardoise, le Cabinet Flourens met cet usage en ordre en six semaines : la carte des usages, des règles acceptées, deux automatisations ou agents IA sur vos outils et le dossier qui prouve ce que l'entreprise a fait.
L'histoire du cabinetMode d'Emploi, la lettre
Une méthode par semaine pour reprendre la main sur votre organisation. Désinscription en un clic.