

Inférence (IA) : les enjeux pour la PME
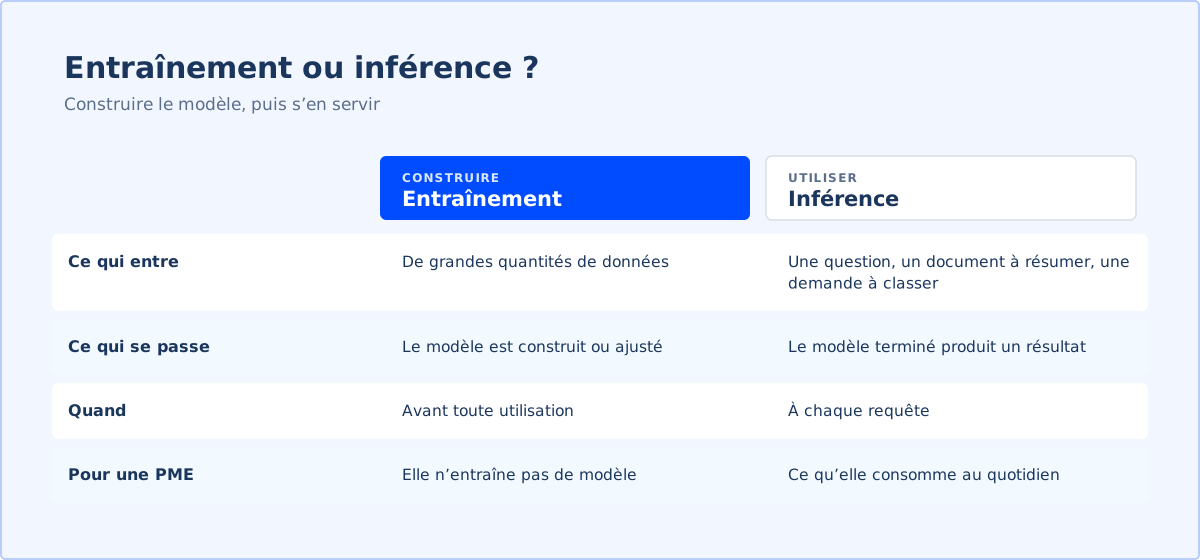
Dans ses recommandations de sécurité pour un système d’IA générative, l’ANSSI précise que la phase de production « peut parfois être appelée phase d’inférence du modèle d’IA » : le modèle réalise alors des prédictions pour des utilisateurs. Pour une PME, presque tout se joue là. Elle n’entraîne pas de modèle ; elle en utilise un chaque fois qu’un salarié pose une question ou qu’une automatisation fait appel à l’IA.
Trois décisions en découlent. Le lieu d’abord : chez l’éditeur, chez un fournisseur cloud ou sur vos propres serveurs, c’est là que transitent vos questions et vos documents, ce qui nourrit le débat sur l’IA souveraine. L’ANSSI recommande de ne jamais intégrer de données sensibles de l’entité dans les requêtes envoyées à des services d’IA tiers grand public. Le volume ensuite : chaque appel consomme des tokens et pèse sur la facture comme sur les délais. Le contrôle enfin : chaque réponse produite reste à vérifier avant usage.
Une même question peut aussi donner deux réponses différentes. La documentation de Claude précise que des entrées identiques peuvent produire des sorties différentes, même avec les réglages les plus stables. Pour qualifier un usage métier, nous testons donc chaque cas sur plusieurs essais, jamais sur un seul. C’est une règle simple à inscrire dans tout projet d’intelligence artificielle.
Exemple
Une entreprise fictive de transport de 140 personnes prépare un assistant qui répond aux questions des conducteurs. Elle estime à 1 200 le nombre de questions mensuelles, dont 30 % portent sur des sujets RH, soit environ 360. Elle compare deux lieux d’inférence et retient un modèle hébergé chez un prestataire en France pour les questions RH, et un service en ligne standard pour le reste.
Questions fréquentes
Que veut dire inférence en IA ?
C’est l’utilisation d’un modèle déjà entraîné pour produire une réponse ou une prédiction. L’ANSSI parle aussi de phase de production.
Une PME fait-elle de l’entraînement ou de l’inférence ?
En règle générale, de l’inférence : elle utilise des modèles existants. L’entraînement ou le fine-tuning relèvent de projets spécifiques, à décider au cas par cas.
Où se fait l’inférence quand on utilise ChatGPT ou Claude ?
Sur l’infrastructure de l’éditeur ou d’un fournisseur cloud partenaire. Vos questions et vos documents y transitent, d’où l’importance des conditions contractuelles.
Pourquoi la même question donne-t-elle deux réponses différentes ?
Parce que la génération n’est pas entièrement déterministe : selon la documentation de Claude, des entrées identiques peuvent produire des sorties différentes. Testez donc sur plusieurs essais.
Sources
- Recommandations de sécurité pour un système d’IA générative (ANSSI-PA-102, v1.0, 29/04/2024), ANSSI — consulté le 16 octobre 2026
- Glossary, Anthropic (documentation Claude) — consulté le 16 octobre 2026
Auteur

Clément Marchal a fondé le Cabinet Flourens. Depuis 2017, dont cinq ans à faire tourner des équipes, notamment dans un environnement régulé par l'AMF, il voit la même chose : l'IA entre dans l'entreprise par les salariés, pas par la direction. Personne ne sait qui l'utilise, sur quelles données, ni ce qu'elle rapporte. Avec Ardoise, le Cabinet Flourens met cet usage en ordre en six semaines : la carte des usages, des règles acceptées, deux automatisations ou agents IA sur vos outils et le dossier qui prouve ce que l'entreprise a fait.
L'histoire du cabinetMode d'Emploi, la lettre
Une méthode par semaine pour reprendre la main sur votre organisation. Désinscription en un clic.