

Fenêtre de contexte : les enjeux pour la PME
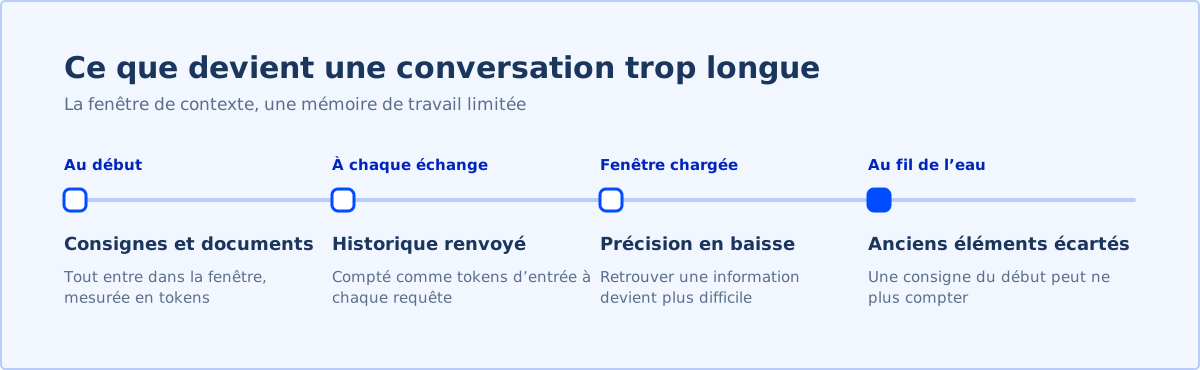
Tout ce que l’on transmet au modèle dans un échange occupe la fenêtre de contexte. Selon la documentation de Claude, cela comprend les instructions, chaque message, les documents et résultats d’outils, ainsi que la réponse générée. Elle se mesure en tokens, pas en pages. Elle se distingue des données d’entraînement du LLM : c’est une mémoire de travail, pas une connaissance acquise.
Une grande fenêtre ne dispense pas de choisir. La même documentation indique que plus le nombre de tokens augmente, plus la précision et la capacité à retrouver une information se dégradent, phénomène qu’elle nomme « context rot ». Coller des centaines de pages en espérant une réponse fiable sur un détail reste un pari. Mieux vaut fournir les passages utiles, ce que fait un système RAG.
Les conversations longues ont aussi un coût caché. L’historique est renvoyé au modèle à chaque nouvel échange et, selon la documentation de Claude, il est facturé comme des tokens d’entrée à chaque requête pour les usages payés à la consommation. Dans les interfaces de discussion, les éléments les plus anciens peuvent en outre être écartés au fil de l’eau : une consigne donnée au début peut ne plus être prise en compte.
Notre réflexe pour les équipes : une conversation par sujet, les consignes importantes rappelées en tête, les documents réduits aux parties utiles. C’est l’une des premières habitudes à installer dans un projet d’intelligence artificielle.
Exemple
Une agence immobilière fictive de 25 personnes utilise un assistant pour analyser des baux commerciaux. Un collaborateur colle 12 baux dans une même conversation et demande les clauses de révision du loyer : l’assistant en omet 3. Repris bail par bail, dans 12 conversations courtes, l’exercice retrouve les 12 clauses, que le responsable juridique vérifie ensuite une à une.
Questions fréquentes
Pourquoi l’IA oublie-t-elle ce que je lui ai dit au début de la conversation ?
Parce que l’échange est devenu trop long pour être traité efficacement, ou que les messages anciens ont été résumés ou écartés. Ouvrez une nouvelle conversation et rappelez les consignes essentielles.
Une plus grande fenêtre de contexte donne-t-elle de meilleures réponses ?
Pas automatiquement. La documentation de Claude précise que la précision se dégrade quand le volume de texte augmente : choisir ce qu’on fournit compte autant que la place disponible.
La fenêtre de contexte a-t-elle un impact sur la facture ?
Pour les usages facturés à la consommation, oui : tout ce qui est envoyé au modèle est compté en tokens, historique de la conversation compris.
Que se passe-t-il quand la fenêtre de contexte est pleine ?
Selon l’outil, la demande est refusée, la réponse s’interrompt ou les parties anciennes de la conversation sont résumées ou retirées.
Sources
- Context windows, Anthropic (documentation Claude) — consulté le 16 octobre 2026
- Glossary, Anthropic (documentation Claude) — consulté le 16 octobre 2026
Auteur

Clément Marchal a fondé le Cabinet Flourens. Depuis 2017, dont cinq ans à faire tourner des équipes, notamment dans un environnement régulé par l'AMF, il voit la même chose : l'IA entre dans l'entreprise par les salariés, pas par la direction. Personne ne sait qui l'utilise, sur quelles données, ni ce qu'elle rapporte. Avec Ardoise, le Cabinet Flourens met cet usage en ordre en six semaines : la carte des usages, des règles acceptées, deux automatisations ou agents IA sur vos outils et le dossier qui prouve ce que l'entreprise a fait.
L'histoire du cabinetMode d'Emploi, la lettre
Une méthode par semaine pour reprendre la main sur votre organisation. Désinscription en un clic.