

Deep learning (apprentissage profond) : les enjeux pour la PME
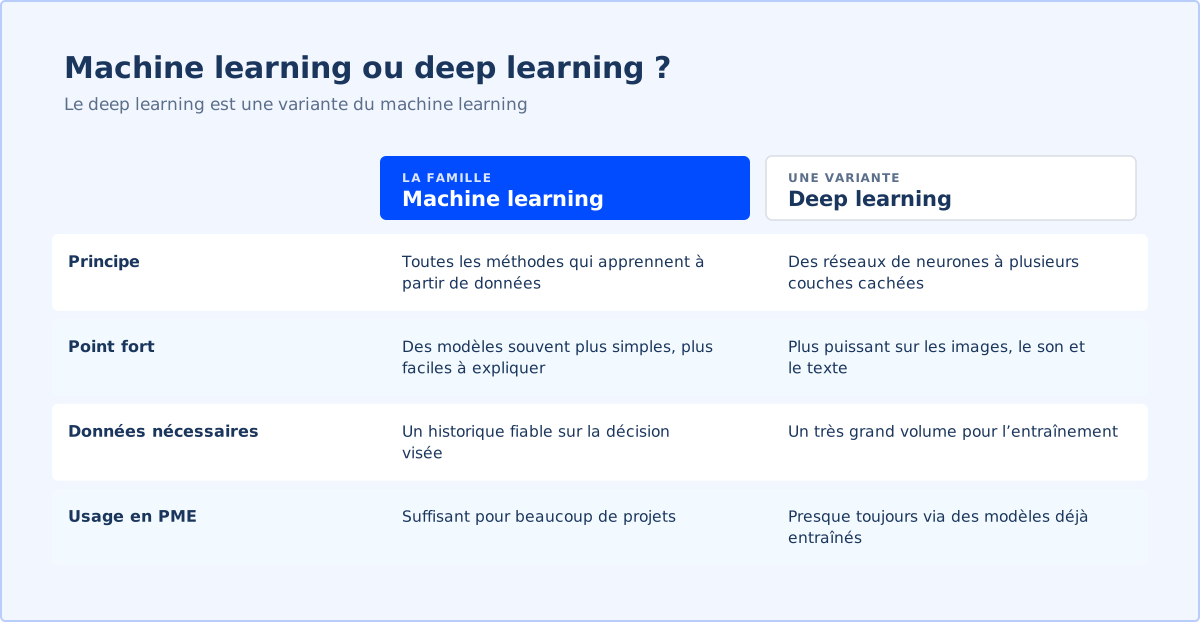
Le deep learning est la technique qui a rendu possibles la reconnaissance d’images, la transcription de la parole et les grands modèles de langage. C’est une méthode de machine learning fondée sur des réseaux de neurones empilés en couches. Comme l’entraînement exige énormément de données, une PME l’utilise presque toujours à travers des modèles déjà entraînés par un éditeur, intégrés à un logiciel ou accessibles en ligne.
La contrepartie est la difficulté d’expliquer un résultat. La CNIL observe que, dans ces systèmes profonds, le nombre de paramètres rend souvent impossible de comprendre d’où vient une erreur. Pour une décision qui touche une personne ou engage l’entreprise, on prévoit donc une validation humaine et une trace de ce qui a été décidé.
Avant d’adopter un outil fondé sur le deep learning, nous conseillons trois vérifications : sur quels types de données le modèle a été entraîné, comment il se comporte sur un échantillon de vos propres cas, et qui corrige ses erreurs au quotidien. C’est souvent plus utile que de comparer les fiches techniques. La fiche intelligence artificielle replace cette technique parmi les autres familles d’IA.
Exemple
Une menuiserie industrielle de 50 personnes contrôle à l’œil l’aspect de ses panneaux. Elle teste un logiciel de vision par ordinateur fondé sur le deep learning, ajusté avec 2 000 photos annotées de son atelier. Sur 500 panneaux de test, l’outil repère 46 des 50 défauts connus et signale 12 fausses alertes. L’entreprise l’adopte en appui des contrôleurs, qui tranchent sur chaque alerte.
Questions fréquentes
Quelle différence entre deep learning et machine learning ?
Le deep learning est une forme de machine learning qui utilise des réseaux de neurones à plusieurs couches cachées. Il traite mieux les images, le son et le langage, au prix d’un besoin de données bien plus important.
Une PME peut-elle faire du deep learning ?
Rarement en partant de zéro, car l’entraînement demande beaucoup de données. En revanche, elle l’utilise couramment à travers des modèles déjà entraînés, intégrés à ses logiciels.
Pourquoi dit-on que le deep learning est une boîte noire ?
Parce que ses très nombreux paramètres rendent souvent impossible de retracer l’origine d’une erreur, comme le souligne la CNIL. D’où l’intérêt d’une validation humaine sur les décisions importantes.
Sources
- Apprentissage profond (deep learning) (définition), CNIL — consulté le 16 octobre 2026
- Intelligence artificielle, de quoi parle-t-on ?, CNIL — consulté le 16 octobre 2026
Auteur

Clément Marchal a fondé le Cabinet Flourens. Depuis 2017, dont cinq ans à faire tourner des équipes, notamment dans un environnement régulé par l'AMF, il voit la même chose : l'IA entre dans l'entreprise par les salariés, pas par la direction. Personne ne sait qui l'utilise, sur quelles données, ni ce qu'elle rapporte. Avec Ardoise, le Cabinet Flourens met cet usage en ordre en six semaines : la carte des usages, des règles acceptées, deux automatisations ou agents IA sur vos outils et le dossier qui prouve ce que l'entreprise a fait.
L'histoire du cabinetMode d'Emploi, la lettre
Une méthode par semaine pour reprendre la main sur votre organisation. Désinscription en un clic.